2026年10月25日,CSA工业互联网安全研究团队第46期组会召开,会议由国际联合实验室博士生赵可景主持。本次组会主题是控制中的网络物理系统:探讨信息物理系统的隐蔽攻击检测与BioMutFed+:面向工业物联网的变异驱动联邦学习。
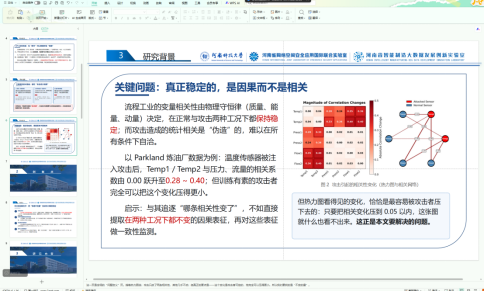
河南科技大学2025级硕士研究生张傲汇报了论文《Attack Detection for Cyber-Physical Systems Based on Causal Representation》,针对 CPS 的攻击与一般信息安全事件存在本质差异,其目标并不在于窃取数据,而是改写物理过程的运行状态。论文给出无监督与有监督两条互补路径。无监督的 USCFE 仅依赖正常工况数据,在主成分分析中引入 L2,1 行稀疏正则以实现“安全感知降维”,让部分传感器的权重整行为零,从而只信任少数**稳健的变量,误报率可压** 1.5%。有监督的 SSCFE 则引入质量变量进行增强,将因果强度、对抗鲁棒性与可检测性三项准则合成单一目标函数。该方法将 20 维测量压缩为 5 维因果表征,召回率达 98.5%。在加拿大 Parkland 炼油厂的真实运行数据上,该方法在 1000 个样本、20 个过程变量的条件下取得 AUC 0.973、误报率 5.5% 的结果,优于 LSTM、Transformer、自编码器等深度学习基线;面对偏差注入、重放、协方差保持与动态攻击四类**攻击,AUC 仍保持在 0.768 ** 0.973 之间。单样本在线检测耗时约 0.6 毫秒、内存占用 1.2 MB,可直接部署于 PLC 或边缘网关,满足流程工业的实时性要求。
河南科技大学2025级硕士研究生曾维超汇报了论文《BioMutFed+: Mutation-Driven Federated Learning for IIoT》。联邦学习(FL)虽能实现“数据不出本地”,但在真实工业场景中面临三大致命痛点:首先是数据高度异构(非 IID),导致模型收敛性能退化高达 40%;其次是对抗环境的脆弱性,传统聚合方法极易被少量恶意客户端投毒,性能暴跌超 60%;**后是边缘设备的资源鸿沟,传统复杂算法让电池受限的工业传感器不堪重负。针对这些痛点,团队提出核心判断:必须将“生物进化的探索机制”与“群体信誉的筛选机制”引入联邦学习,并在“满配防御”与“**轻量”之间提供双轨解决方案。
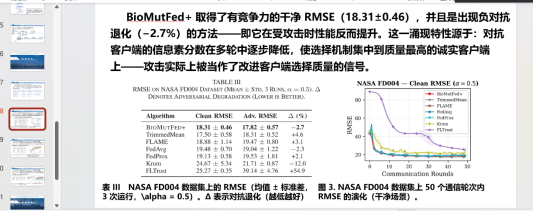
在方法层面,论文给出了两套互补的优化框架:满配版 BioMutFed+ 打造了三重防御闭环。其一,引入基于“信息素”的客户端选择机制,追踪历史贡献动态奖优罚劣,从源头屏蔽恶意节点;其二,在本地更新中注入自适应高斯变异(噪声扰动),帮助模型跳出非 IID 数据的局部**优陷阱;其三,在服务器端采用中位数与截断平均(Median + Trimmed-Mean)的混合鲁棒聚合,剔除极端异常值。该方法在 NASA FD004 预测性维护、威斯康星乳腺癌诊断及 Digits 视觉分类三大真实/基准数据集上进行了验证。在 20% 恶意客户端攻击的极端环境下,BioMutFed+ 不仅实现了 20 轮内的快速收敛,方差降低 1.2 ** 2.9 倍,且在 FD004 任务中呈现逆势提升(对抗退化率为 -2.7%)。在工程落地维度,FedMutAdam 的服务器端额外计算开销仅为经典 FedAvg 的 1.5 倍,能够**兼容各类算力受限的工业边缘网关与传感器节点,为下一代工业 5.0 提供了可落地、高安全的自适应智能引擎。
在交流环节,与会组员围绕中因果表征与端到端深度模型的对比展开讨论,指出黑箱模型既难以保证泛化,一旦误报也难以给出可追溯的解释,需要通过多种方式加以应对,在技术层面强化可解释性与可信人工智能,把物理机理与因果约束作为模型的安全边界;在制度层面完善标准、评估与责任划分;在工程层面保留必要的非数字化替代方案与人工复核环节,以增强系统的整体韧性。