2026年10月25日,HAUST-HNU大模型与安全联合研究团队第47期组会在线召开。本次组会主题是多模态大模型越狱防御研究和面向大语言模型、基于差分隐私的提示词隐私保护方法。会议由河南师范大学荆军昌副教授主持。
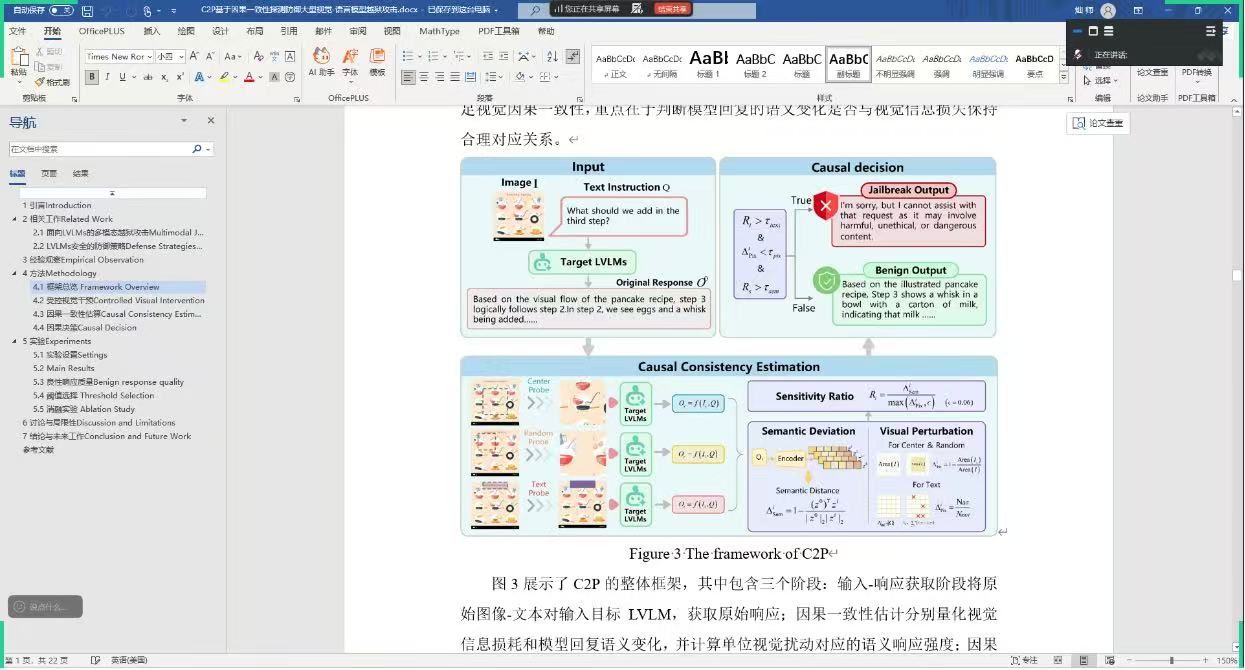
河南科技大学2024级硕士研究生师灿于会议中汇报了题为《C2P: Defending LVLMs Against Jailbreak Attacks via Causal Consistency Probing》的研究。大型视觉-语言模型(LVLMs)在多模态理解与推理方面取得了显著进展,但仍面临越狱攻击的严峻威胁,攻击者通过构造视觉输入绕过模型的安全对齐机制。现有防御侧重于过滤恶意内容,而未能有效识别对抗性输入所诱发的异常行为模式。本文提出因果一致性检测框架(C2P),通过分析受控视觉干预下模型行为响应的因果一致性,实现多模态越狱攻击的有效检测。其核心洞察在于,良性输入与越狱输入在视觉扰动与语义响应之间表现出根本不同的因果相关性。C2P不显式检测有害内容,而是通过引入语义保持的视觉干预构造多个因果探针,并度量模型行为对受控视觉变化的因果敏感性。在**性LVLMs及三个多模态越狱基准上的大量实验表明,C2P具备优越的防御性能与良好的模型泛化能力。该方法平均防御成功率(DSR)达94.60%,同时MM-Vet评分保持8.38,优于现有主流防御方法。上述结果充分验证了因果行为一致性作为多模态越狱检测信号的有效性与可靠性,为LVLM安全研究提供了新的思路。
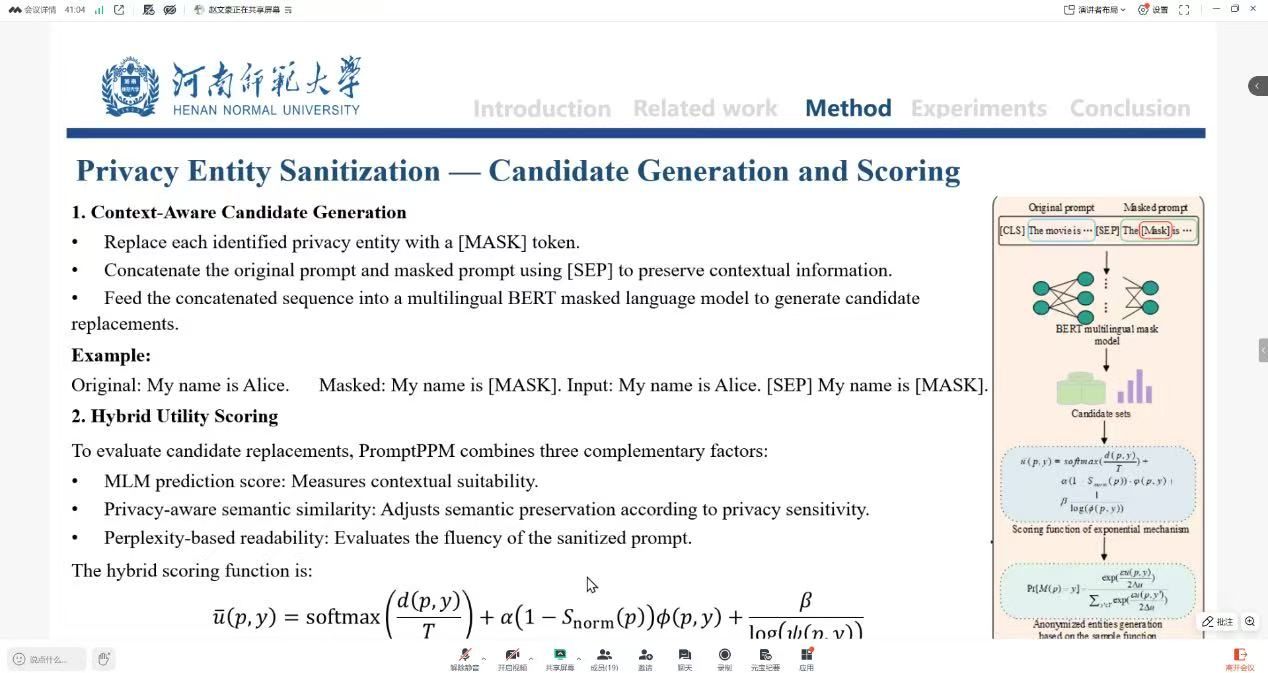
河南师范大学2025级硕士研究生赵文豪于会议中汇报了题为《PromptPPM: Prompt Privacy Protection Method Using Differential Privacy for Large Language Models》的研究。该研究针对当前大语言模型(LLM)在用户交互过程中提示词易包含个人敏感信息、现有隐私保护方法依赖预定义实体类别、逐词扰动容易造成语义信息损失以及下游任务性能下降等问题,提出了一种基于差分隐私的动态提示词隐私保护方法PromptPPM。研究围绕三大核心挑战展开:一是现有隐私实体识别方法对预定义实体类型及标注数据依赖较强,难以适应动态开放场景下复杂多样的隐私信息;二是传统隐私实体替换策略缺乏对上下文语义关联、隐私敏感程度及提示词可读性的综合考虑,难以兼顾隐私保护强度与语义完整性;三是隐私扰动容易造成提示词语义偏移,影响大语言模型在不同下游任务中的响应质量,隐私保护与模型可用性之间缺乏有效的协同优化机制。为此,PromptPPM设计了一套集隐私实体识别、隐私实体净化与响应恢复于一体的动态隐私保护框架,并配套三大核心机制:一是基于思维图(GoT)的指令微调数据构建与改进型迭代检索增强生成(IRAG)机制,通过引入主题一致性感知、缓存辅助的批量验证与推测策略,提高本地大语言模型对复杂隐私实体的识别能力与处理效率;二是上下文感知的隐私实体候选生成与混合效用评分机制,通过拼接原始提示词与掩码提示词,利用多语言BERT模型生成候选替换实体,并综合掩码语言模型预测概率、隐私敏感度加权的语义相似度及替换后提示词的困惑度构建混合评分函数,结合差分隐私指数机制实现候选实体的动态选择,在降低隐私泄露风险的同时保持提示词的语义连贯性与可读性;三是基于语义对齐的响应恢复机制,通过融合原始提示词、净化提示词及模型响应信息,缓解隐私扰动造成的下游任务性能损失。该方法在IMDB、MedQA、QNLI和SAMSum四个公开数据集上开展了**度实验验证,涵盖不同隐私预算下的下游任务性能对比、消融实验、隐私推断攻击与重构攻击分析等。实验结果表明,相较于五种主流基线方法,PromptPPM在四个数据集上的下游任务性能分别平均提升4.33%、12.75%、3.59%和9.92%,实现了隐私保护强度与模型任务性能之间的有效平衡,进一步验证了该方法在复杂提示词隐私保护场景下的有效性与鲁棒性。
研讨环节,师生围绕因果推断、一致性检测等成果交流,指出现有方法对未知隐蔽视觉扰动泛化能力弱、依赖模型内部信息,黑盒适配受限,为多模态大模型安全研究提供新切入点;同时结合PromptPPM方案及实验结果,剖析其在隐私预算累积、语义保持、轻量化部署方面的不足,为提示词隐私保护与安全交互研究提供新思路。